开场:二周目玩家入场
去年,我写了《一层薄膜的厚度,一束光的往返》,复盘 2025 年 B 题的碳化硅红外测厚。那篇文章的反思区里有七条「如果重来」——现在,它们成了我带进赛场的攻略笔记。
是的,我又来了。
| 2025 · B 题(一周目) | 2026 · A 题(二周目) | |
|---|---|---|
| 物理对象 | SiC 外延层上的红外干涉光谱 | 圆柱药材里的热传导与水分扩散 |
| 问题性质 | 逆问题:从条纹反演厚度 | 正问题:把 PDE 往前推,推到达标为止 |
| 核心难点 | 参数简并( 与 纠缠) | 时间尺度悬殊(热快湿慢,差 34 倍)+ 移动边界 |
| 交付物 | 一个厚度数字(μm 级) | 一个烘干时间(小时级)+ 全程时空分布 |
| 最大的坑 | 材料参数张冠李戴,错误互相抵消 | 经验公式少看一条分数线(后文详谈) |
如果说去年是「从一束光里读出一个数」,今年就是「陪一根药材走完它的一生」——从 28 °C、含水率 2.55 kg/kg 的鲜药材,到 57.93 小时后全身各处都干燥合格的成品。这篇文章会认真讲 A 题本身:模型怎么建、求解器怎么写、答案怎么验证;然后是那个差点让我们团灭的 bug;最后聊聊一个去年还不存在、今年被组委会正式写进规则的东西——AI 工具使用声明。
题目思考:这题到底在问什么
背景:一根药材的脱水之旅
中药材采下来不能直接进药房,得先烘干——含水量太高会霉变,烘过头了又破坏有效成分。工业上靠热风对流干燥:热风把热量吹进药材,水分再从内部迁移到表面被气流带走。工艺参数长期靠老师傅的经验和反复试烘,成本高、周期长。这道题想让我们做的事情,是把试烘换成数值仿真。
题目给的研究对象是一根长 25 cm、半径 2 cm 的圆柱形药材,初温 28 °C,初始干基含水率 2.55 kg/kg(也就是每 kg 干物质背着 2.55 kg 水——药材刚采下来时水灵得不像话)。数据方面:附件 1 给出烘干初期 4 小时内烘房温度与水分浓度的变化曲线,附件 2 给出 72 小时内药材半径从 2.000 cm 收缩到 1.198 cm 的实测规律。
四问层层递进,像一条设计好的主线任务:
flowchart TD
    A["圆柱药材<br/>25 cm × R 2 cm<br/>2.55 kg/kg 的含水量"] --> B
    subgraph S1["问题一 · 建框架"]
        B["预热平衡阶段 30 min<br/>常物性,温度场可独立求解<br/>有 Bessel 解析解当裁判"]
    end
    B --> C
    subgraph S2["问题二 · 升物性"]
        C["烘干全过程前 3 h<br/>变物性,温度-水分双向耦合<br/>Picard 迭代线性化"]
    end
    C --> D
    subgraph S3["问题三 · 拉时间"]
        D["模拟到烘干合格<br/>各处 C ≤ 0.15 kg/kg<br/>反演最短烘干时长"]
    end
    D --> E
    subgraph S4["问题四 · 修几何"]
        E["计入失水收缩<br/>区域随时间缩小<br/>移动边界问题"]
    end
我当时的理解:这是一道「正问题 + 判定问题」的组合
去年 B 题是逆问题——光谱数据已经躺在表格里,难的是从条纹间距把厚度「抠」出来,而且要命的是 简并:折射率和厚度缠在一起,分开它们全靠折射率的先验。今年 A 题完全反过来:
- 模型是正的:控制方程、边界条件、初始条件全部已知,物性参数由赛题附录的经验公式给定,不存在「从数据反演物理」的环节;
- 难点在数值:热扩散系数量级 ,水分扩散系数只有 且随失水指数衰减——温度场几十分钟就平衡,水分场要跑好几天,这种刚性(stiff)多尺度结构要求时间离散无条件稳定;
- 判定要连续化:问题三的「烘干时间」不是某个采样点,而是 穿越 0.15 的精确时刻,需要插值求根;
- 问题四埋了个真家伙:失水收缩让计算区域随时间缩小,这是货真价实的移动边界问题(Stefan 类问题的亲戚),处理不好要么网格重构做到天荒地老,要么边界通量算错还不知道。
去年复盘时我写过一句话:「条纹间距只能确定 这个乘积」。今年的等价句是:「烘干时间由最慢的那个点决定,而最慢的点永远在中心」——所以任何「平均含水率达标」的偷懒判据都会系统性低估工期。这句话后来成了问题三的关键结论之一(平均口径会低估 37%)。
统一框架:热质耦合方程组
控制方程
四个问题共用同一副骨架。取圆柱轴线为 ,只考虑径向传递(长径比 12.5,端面面积仅占 7.4%,这个简化写进了假设 1),温度 与水分浓度 满足柱坐标下的抛物型方程组:
中心对称、表面对流(Robin 边界):
物性参数是耦合的来源:、、、 全都随 和 变化(附录 3 给出 这样的双指数经验式),温度方程的系数依赖水分场,水分方程的扩散系数又依赖温度场——双向耦合,每个时间步内用 Picard 迭代解开。
先算特征数,再写代码
今年的第一个进步:没有急着建模,而是先算了一组无量纲特征数,让物理结构自己说话:
| 特征量 | 定义 | 数值 | 它在说什么 |
|---|---|---|---|
| 热扩散特征时间 | ≈ 39.5 min | 与预热阶段时长吻合 | |
| 热毕渥数 | 1.39 | > 0.1,集总参数法失效,必须分布建模 | |
| 质扩散特征时间 | ≈ 22.5 h | 水分扩散是全程控制步骤 | |
| 传质毕渥数 | 3.24 | > 1,内部扩散阻力占优 | |
| 路易斯数 | 2.9 × 10⁻² | 热比湿快约 34 倍 |
这张表的价值在于:它在写任何一行代码之前就预言了整道题的叙事结构——「预热快、干燥慢」的两阶段工艺不是经验玄学,是 的必然推论;问题三答案的量级应该贴着 的倍数走(最终 57.93 h ≈ 2.6 个 ,自洽)。先让量级分析跑在代码前面,这是去年「错误互相抵消而不自知」教我的第一件事。
求解器内核:守恒型有限体积 + Crank–Nicolson + Picard
空间离散用守恒型有限体积法(控制体取圆环,面通量按 加权,内部通量两两相消、只剩边界项——守恒性从格式层面白送),时间积分用 Crank–Nicolson(无条件稳定、二阶精度,刚性问题的刚需),非线性系数用 Picard 迭代半隐式处理。柱坐标 的奇异性不特判:核心节点取半控制体 ,L'Hôpital 极限自动给出 的正确系数。三对角系统用 Thomas 追赶法 解掉。
核心循环长这样(约 170 行的 fv_cyl.py 是全项目的发动机):
for n in range(nsteps):
    env_n, env_np1 = robin_env(t0, t1)
    env_cn = 0.5 * (env_n + env_np1)          # CN 折中环境值

    k_old, kf_old = faces(C)                  # 节点系数 → 界面调和平均
    F_old, A_old, B_old, G = explicit_F(C, kf_old, env_n)
    rhs = [C[i] + dt * (1.0 - theta) * F_old[i] for i in range(N + 1)]
    rhs[N] += dt * theta * G * env_np1        # Robin 边界隐式进主对角元

    Cnew = list(C)
    for m in range(max_picard):               # Picard:系数取最新迭代值
        _, kf_new = faces(Cnew)
        # …用 kf_new 重组三对角 lower/diag/upper…
        sol = thomas(lower, diag, upper, rhs)
        if max(abs(sol[i] - Cnew[i]) for i in range(N + 1)) < tol:
            break
        Cnew = sol
C = Cnew界面系数的调和平均()是个容易忽略的细节:变物性下相邻节点的扩散系数可以差出数倍,算术平均会高估界面通量,调和平均保正且与梯度同号——干壳边界层里这种差别会被放大。这个选择来自 Patankar 的经典教材,写代码前翻了书。
四问速通
问题一:让解析解当裁判
预热阶段物性为常数、温度场与水分场单向解耦——温度场是线性问题,可以独立求解,而且圆柱对流边界下存在 Bessel 级数解析解。这是出题人送的礼物:有解析解,就意味着数值格式可以被「审判」而不是「自夸」。
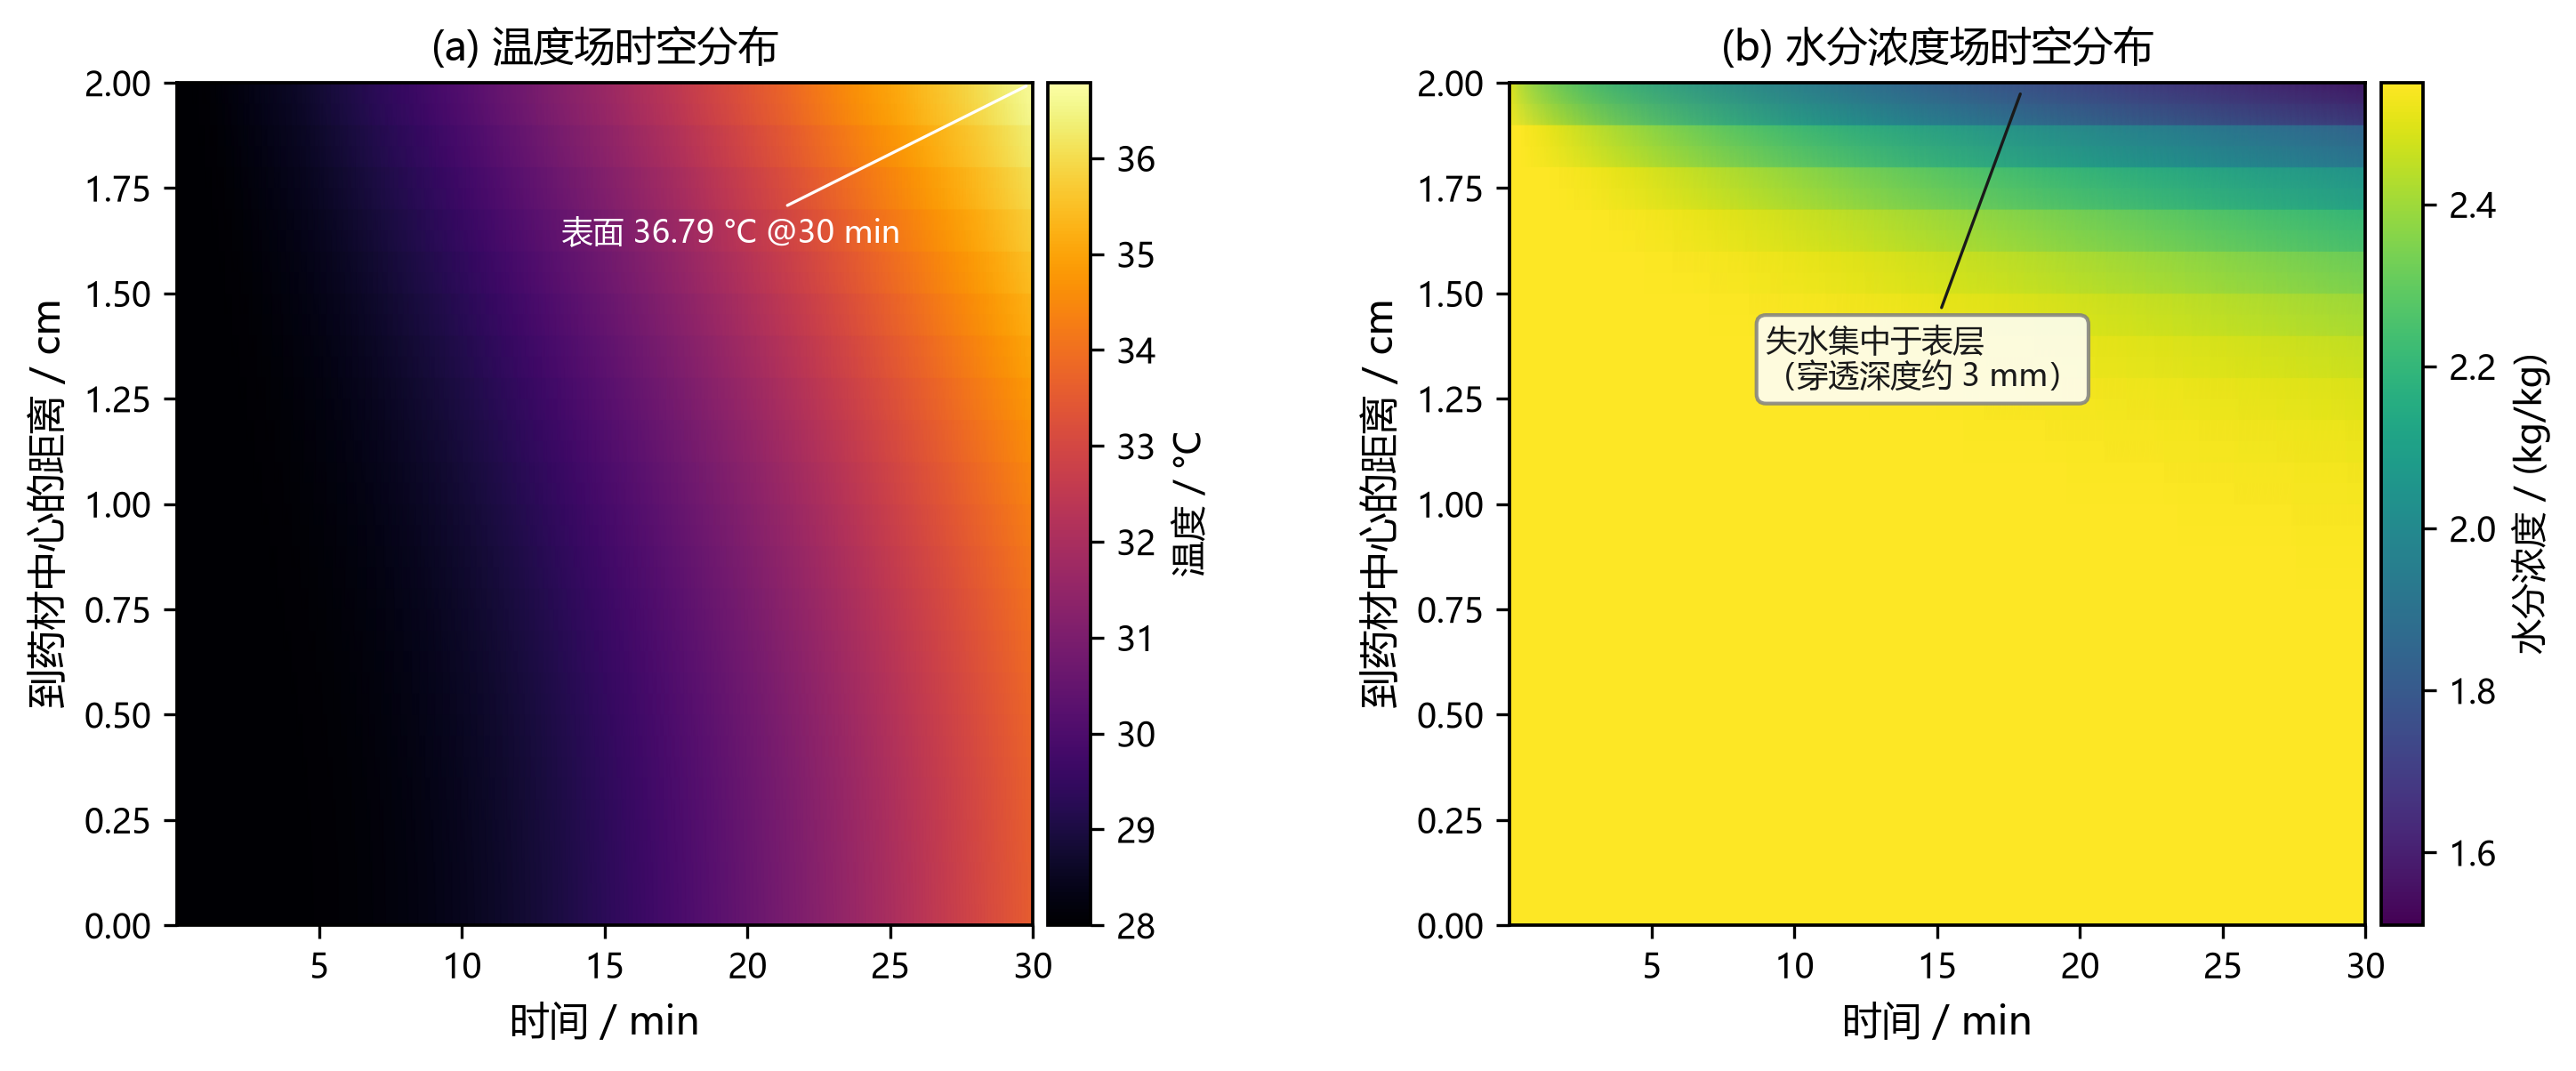
我们把数值解和解析解逐点对比,最大偏差不超过 。30 min 末,药材中心升至 33.58 °C、表面 36.79 °C(环境温度 50 °C 附近,远未平衡);失水集中在表层约 3.0 mm 的薄层里,体积平均含水率仅降约 10%——预热阶段确实主要是「热」的事,「湿」的故事才刚翻开扉页。
问题二:双向耦合,干壳登场
把 、、、 全部计入后,两个场真正缠在一起:每个时间步内交替更新物性与场量直到收敛。3 h 末温度场已接近均衡( 的预言兑现),水分场则呈现「表面先干、锋面向内推进」的标准剧情。两个值得记住的数字:
- 扩散系数随失水衰减约 17 倍()——越干越慢,干燥后期扩散能力近乎塌缩;
- 约 24 h 后表层结成干壳,干燥转入壳内缓慢渗流阶段。这就是现实中「外干内湿、品相报废」的定量图像,也是工艺上最怕的「干壳—湿芯」结构。
问题三:58 小时是怎么数出来的
以「各处水分浓度均降至 0.15 kg/kg 以下」为合格判据,把模拟拉长到 8 天。这里有两个今年做得比较认真的地方:
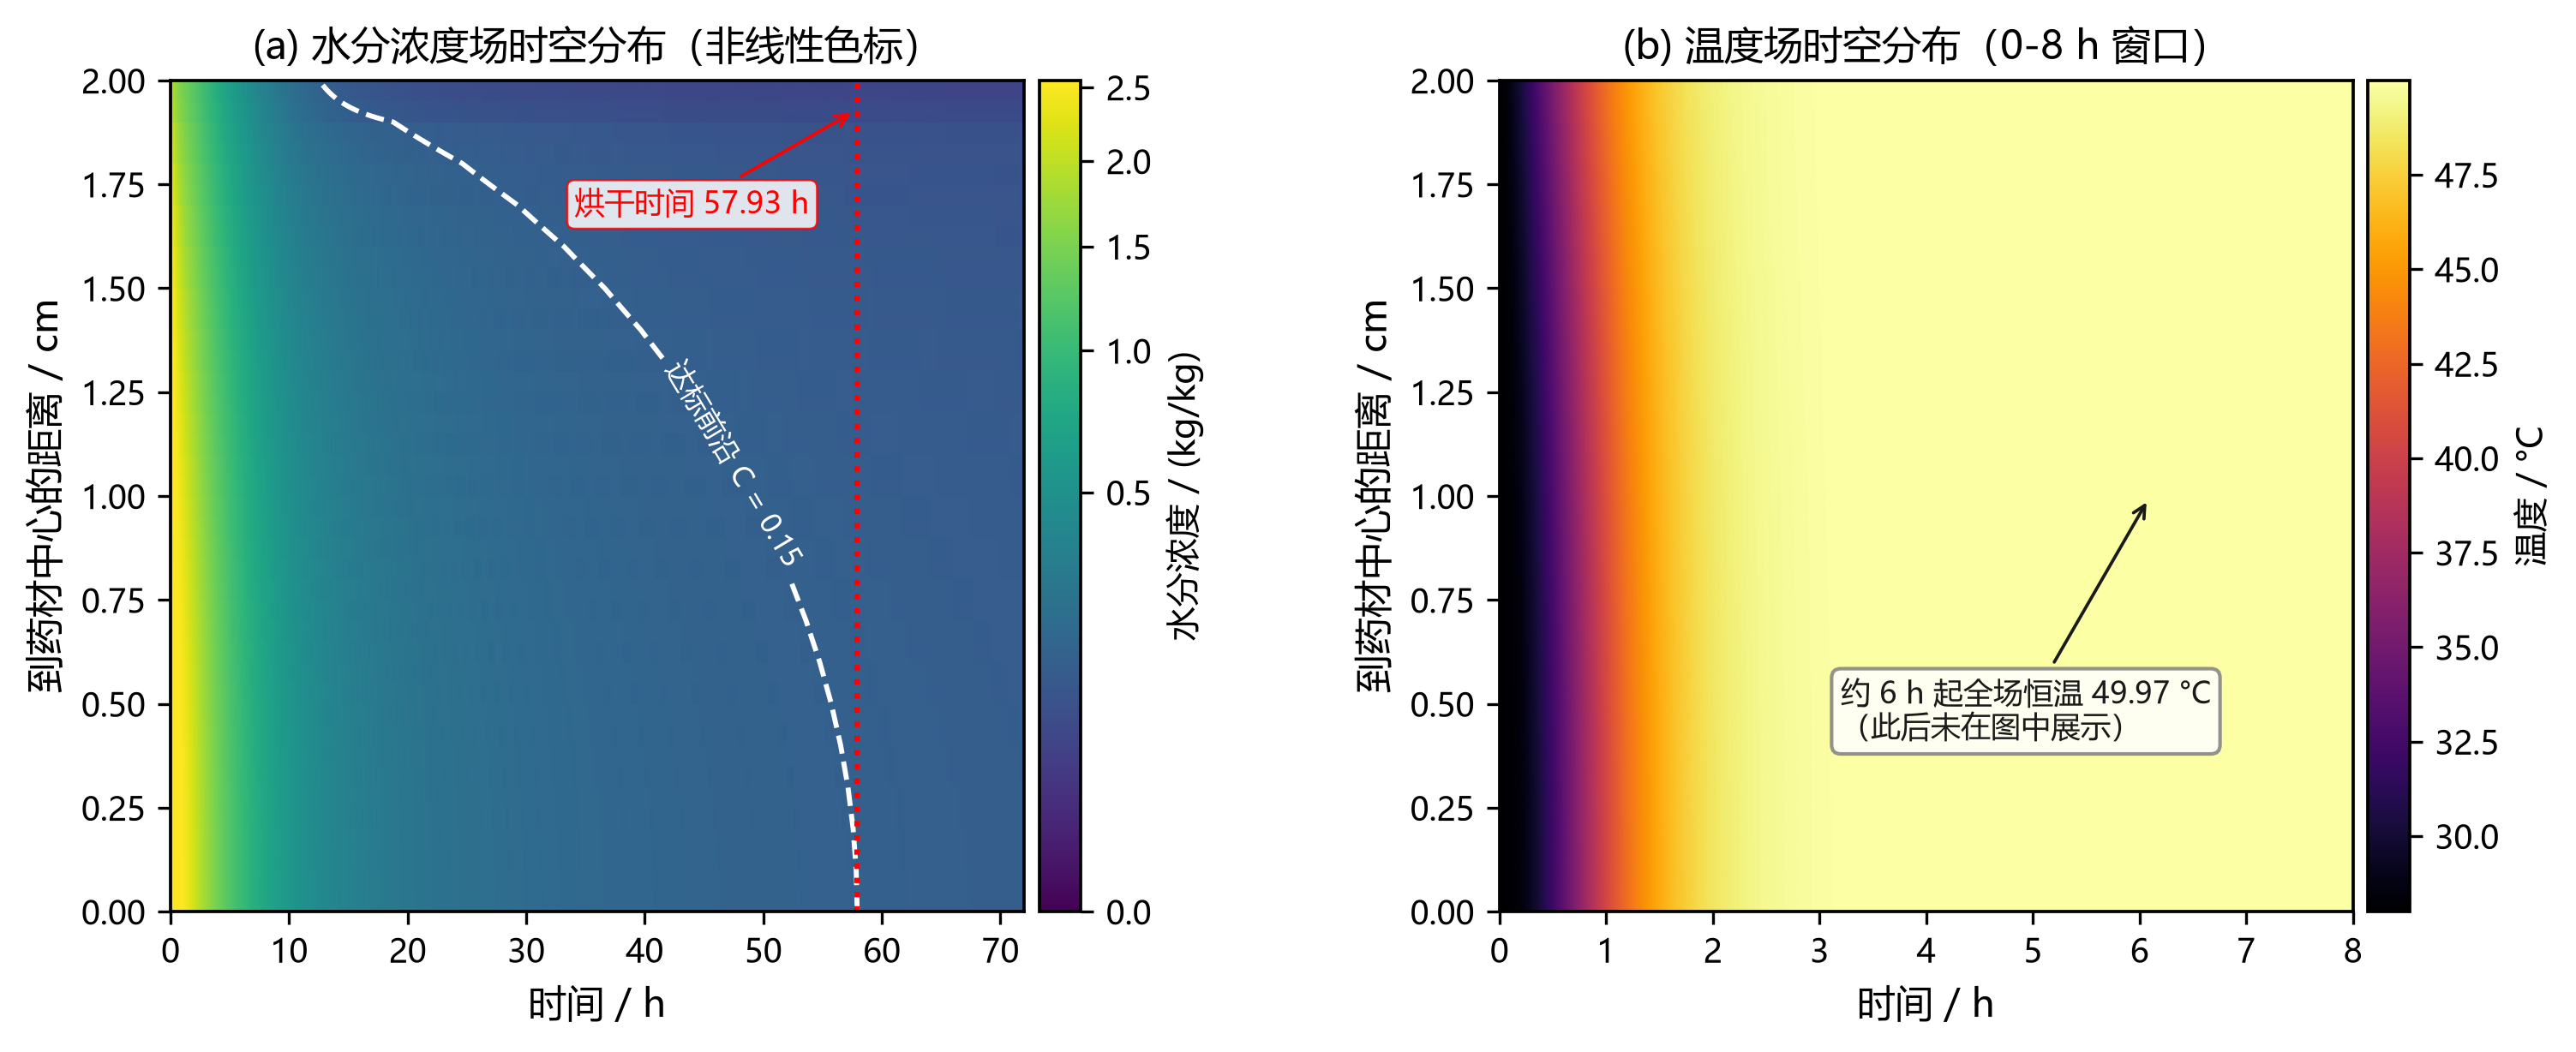
其一,判据用全场极值而不是平均值。 逐步扫描 并记录其位置(验证最慢点确实始终在中心 ),而不是用体积平均含水率偷懒。事后对比三种口径:表面达标 12.55 h、平均达标 36.69 h、处处达标 57.93 h——平均口径把工期低估 37%,排产按它来就是变成大事故了喵。
其二,终止时刻连续化。 57.93 h 不是某个时间步的标签:对 序列做 PCHIP 保形插值再二分求根,把穿越时刻确定到 s(物理上没意义,但消除了「时间步抖动」这个噪声源):
def crossing_time(ts, ys, level=0.15):
    # 定位首个低于 level 的采样点 k,取其邻域窗口
    xs, vs = ts[k-6:k+7], ys[k-6:k+7]
    f = pchip(list(xs), list(vs))          # 保形插值,不过冲
    a, b = ts[k-1], ts[k]
    fa = f(a) - level
    for _ in range(200):                   # 二分求根
        m = 0.5 * (a + b);  fm = f(m) - level
        if fa * fm <= 0.0: b = m
        else:              a, fa = m, fm
        if b - a < 1e-10: break
    return 0.5 * (a + b)
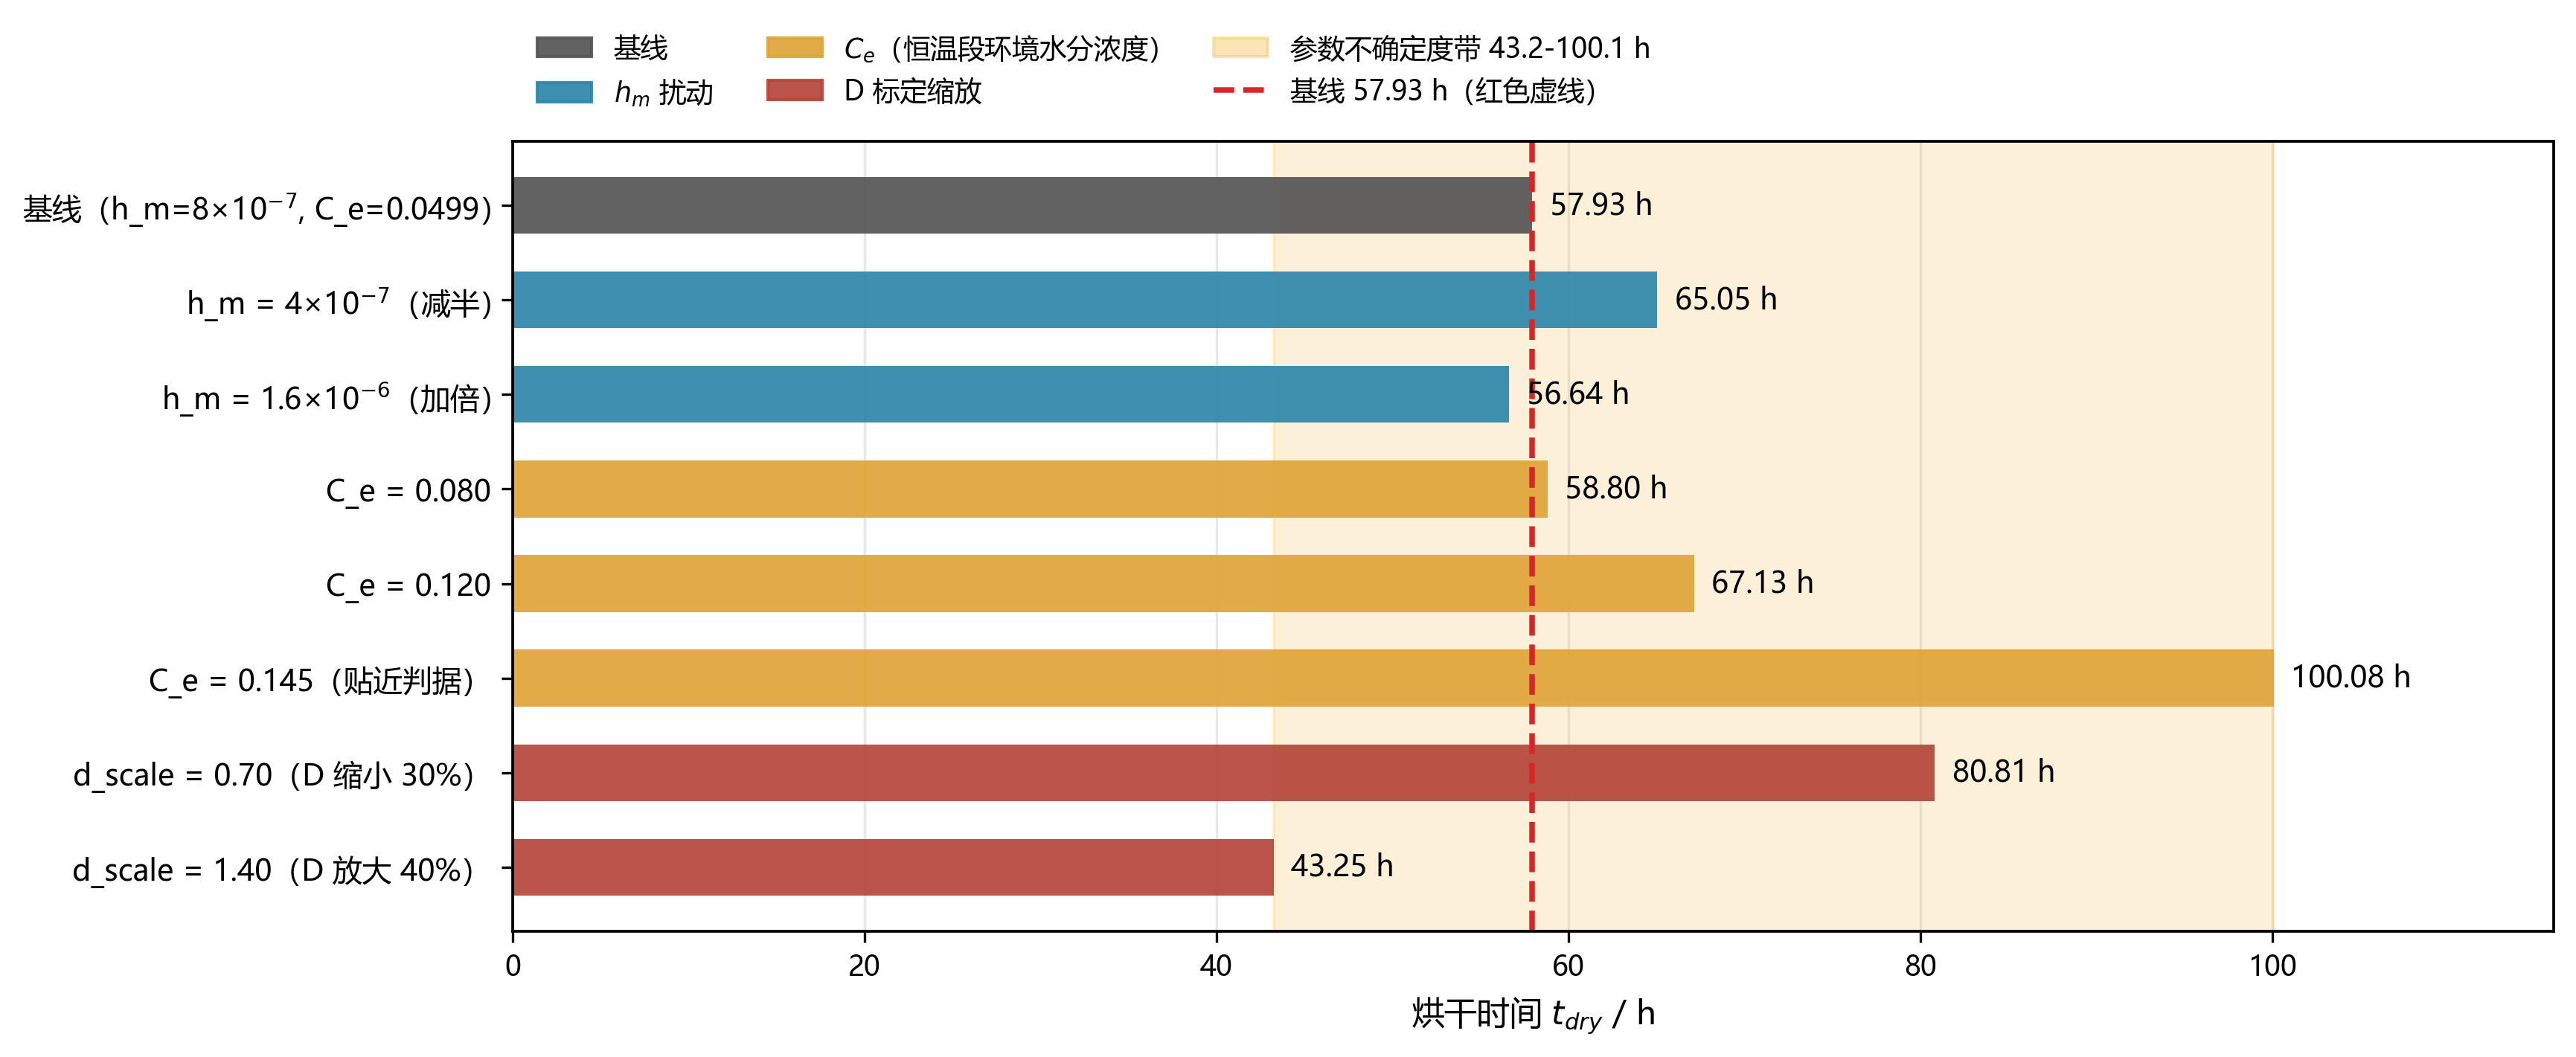
最终答案:烘干时间 57.93 h,约 2.4 天,落在题面「2–3 天」的工艺经验区间内。但今年的报告口径比去年成熟了一点——不只报一个数,而是三层口径:单值 57.93 h + 离散偏差区间 h(网格收敛序列外推,宽 0.77%)+ 参数不确定度带 43–100 h(恒温段环境参数与扩散系数标定的 ±30% 扰动扫描)。
问题四:Landau 变换,今年写得最快乐的一段推导
问题四计入失水收缩:计算区域 随时间缩小,移动边界问题。标准做法是 ALE 动网格——但去年被「网格级工程债」教育过的我,今年一看到「动网格」三个字就想找解析出路。
引入材料坐标 。关键一步是承认药材骨架本身在以 作刚性收缩,水分总通量是扩散与随体对流之和:
代入守恒律并变换到 坐标,展开后四项中含 的部分——坐标变换附加对流、容量变率、随体对流贡献、随体通量散度——两两相消,最终得到一个漂亮到不像话的固定域方程:
移动边界的全部几何信息被解析地吸收进标量因子 ,不用动网格、不用插值映射,沿用前述守恒格式直接求解。与去年问题三那段「写得最快乐的 20 行波数差法」遥相呼应——每年都会有那么一个瞬间,推导自己收敛成一行,那种快乐是建模比赛的隐藏掉落。
离散时唯一需要甄别的是标度的不对称性:扩散电导 (容量随 收缩),而表面 Robin 通量 (边界面积只随 收缩)。混同二者, 收缩 40% 时边界阻力就被悄悄低估 40%,答案系统性偏快——而且这种错守恒检验不报警,因为我们靠移动边界与固定域两个独立内核的对算(偏差 )才锁死了它。
# 电导  K_i(t) = coef_{i+1/2}*a_i / (R(t)^2*dxi)         ~ 1/R^2
# Robin KR(t)  = k_R*a_R / R(t)                          ~ 1/R(表面积~R、容量~R^2)
# 注意 Robin 项是 1/R 而非 1/R^2;误写成 1/R^2 会低估边界阻力。
问题四还有个反直觉的剧情:附件 2 的收缩数据与附录 4 的物性公式是两股方向相反的力。三算例定界显示——附录 4 的扩散系数整体明显偏小,单独作用时 120 h 内都烘不干(减速);而半径收缩 40% 经 因子把等效扩散能力放大约 2.8 倍(加速)。两股效应部分抵消后,烘干时间 51.53 h,较问题三缩短 11.0%。
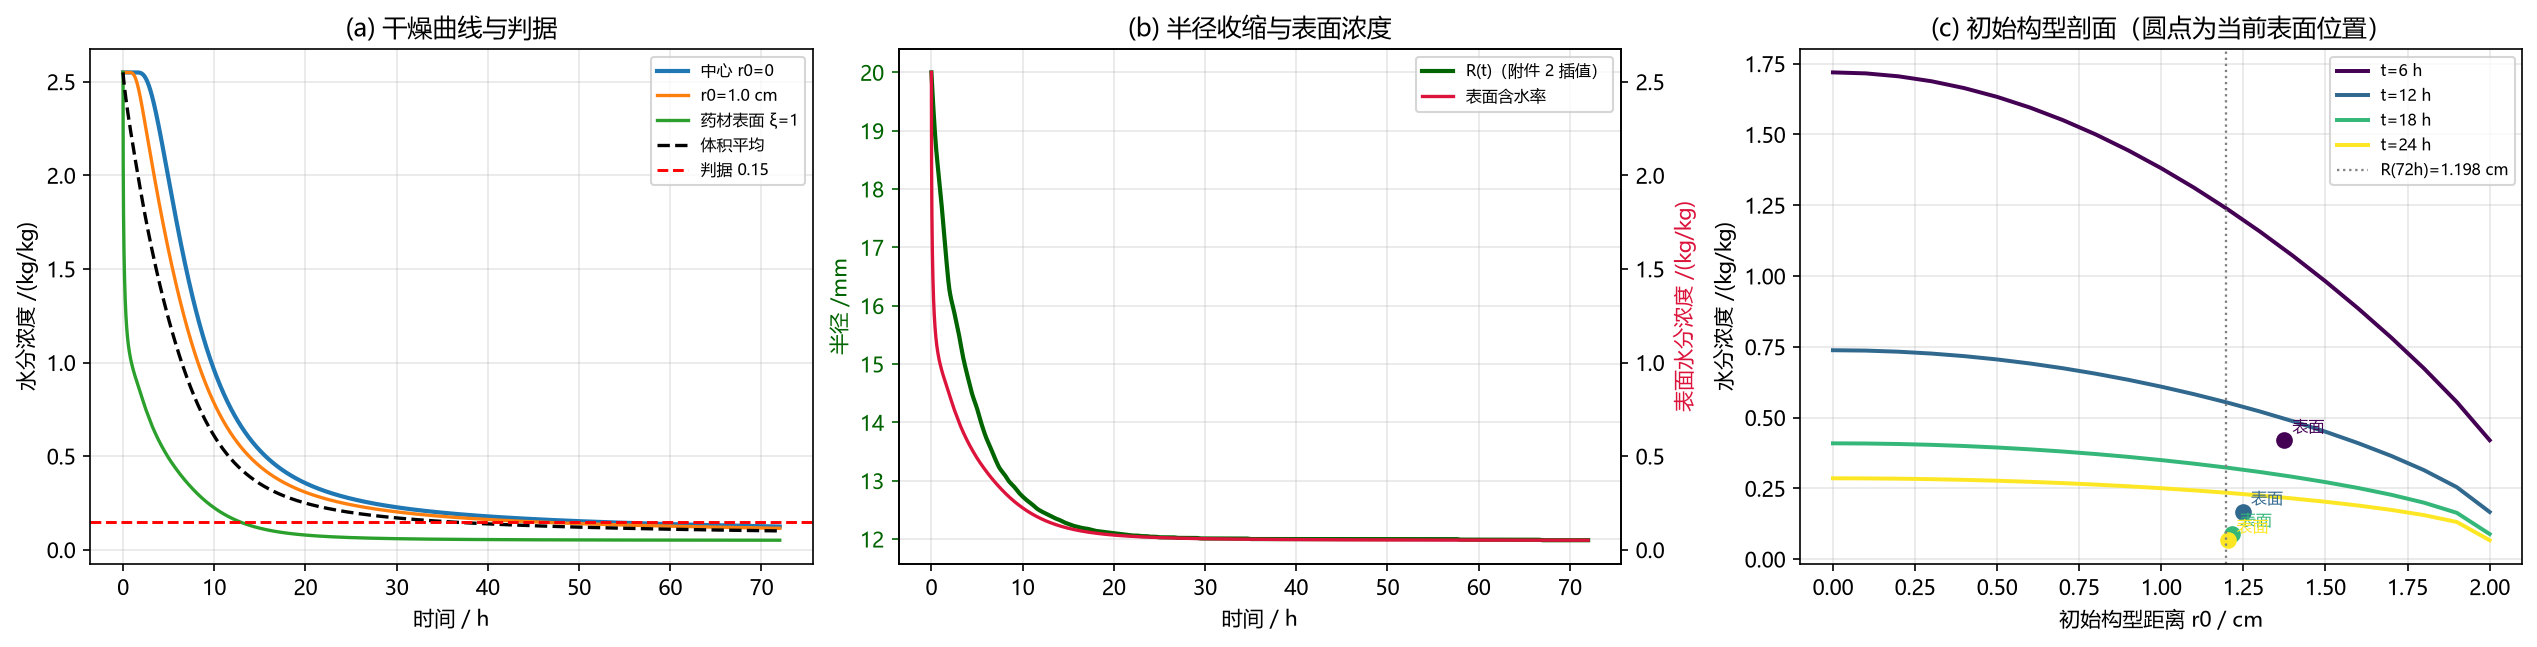
全题结果一览
| 问题 | 核心方法 | 结果 | 校验 |
|---|---|---|---|
| 一 | 常物性解耦 + Bessel 级数对照 | 30 min 末中心 33.58 °C / 表面 36.79 °C,失水 10.1% | 与解析解偏差 ≤ 1.6×10⁻⁴ |
| 二 | 变物性双向耦合 + 块迭代 | 3 h 时空分布; 衰减 17 倍,24 h 表层成干壳 | 72 h 窗口网格偏差 ≤ 0.065% |
| 三 | 极值追踪 + PCHIP 连续化求根 | 烘干 57.93 h ≈ 2.4 天(平均口径低估 37%) | 离散区间 [57.49, 57.93] h;不确定度带 43–100 h |
| 四 | Landau 材料坐标 + 三算例定界 | 烘干 51.53 h,较问题三提前 11.0% | 移动/固定双内核对算偏差 2×10⁻¹⁴ |
全局守恒检验:质量残差 、能量残差 ,贴着机器精度。
那个差点团灭的 bug:一条看不见的分数线
好了,上面都是光亮的部分。现在讲这场比赛真正的「剧情杀」。
赛题附录的扩散系数经验公式是 ——指数里是分数, 在分母上。而代码里最初实现的是 7e-9 * exp(-0.89 * c)——分数线被读丢了, 从分母跑到了乘数上。
这两种写法在初始含水率 处就差了近 7 倍,更要命的是物理趋势完全相反:
| 分式形式(赛题原式) | 乘积形式(错误实现) | |
|---|---|---|
| :2.55 → 0.15 | 衰减约 17 倍,越干越慢 | 不降反升,越干越快 |
| 物理图像 | 后期扩散塌缩,干壳形成 | 后期加速,干燥永不刹停 |
| 问题三答案 | 57.93 h ≈ 2.4 天 | 16.47 h |
错误实现给出的 16.47 h 与题面「烘干一般持续 2–3 天」的经验提示正面冲突——正是这个矛盾逼着论文手回到赛题 PDF 原图逐字符核对,发现指数位置那条清晰的分数线。修正、重跑,全部口径一夜之间从「互相打架」变成「自洽闭环」。
为什么我要把这件事放在复盘的核心位置?因为它和去年的「案发现场」构成了一组完美的镜像:
- 去年:柯西系数张冠李戴(SiO₂ 的折射率算 SiC),级次低估的 1.75 倍恰好被折射率低估的 1.73 倍抵消,数字漂亮、模型全错,错误互相伪装成正确;
- 今年:公式少看一条分数线,物理趋势整个反转,但题面给出的「2–3 天」经验量级像警报器一样响了,矛盾拒绝被忽视,第三天之内就被抓住。
差别不在运气,在工作方式:今年我们刻意在流程里埋了「锚点」——题面的经验区间、Bessel 解析解、守恒残差、双内核对算——任何一个数字都必须同时让多个独立来源点头。去年的模型是一座「自圆其说的世界」,今年的模型更像一间「到处是监控的实验室」。16.47 h 如果出现在去年,大概率会被我们写进摘要然后高高兴兴交上去;今年它活不过一个晚上。
工程:把去年的七条反思逐条兑现
去年反思区的最后一条是工程债:四个复制粘贴的脚本、散落的魔法常数、print 出来给人看却不参与决策的 FFT 验证。今年交卷前的工程状态,可以直接和去年对照:
| 去年(一周后诊断出的病) | 今年(开赛前就开好的药) |
|---|---|
| 四份脚本两两 90% 相同 | q1–q4 目录 + common/ 统一实现,Thomas 追赶与 PCHIP 全项目各一份 |
| 假设清单是补写的装饰品 | 每条假设在论文里有编号、在灵敏度分析里有量化背书(如 、 扰动 ±50% → 烘干时间变化 ≤ 4.4 h) |
| 「看起来合理」就采信 | 守恒残差 + 解析解对照 + 网格收敛阶 + 跨内核对算,四道闸门 |
FFT 验证只 print 不决策 | 网格收敛直接驱动生产网格选型: 高估烘干时间 55%、 仍偏高,生产网格定为 |
| 结论与证据脱钩(「修正了多光束干涉」其实没有) | 每个交付文件与生成脚本一一对应,写进论文附录的对照表;另有一份独立的代码审计报告 |
| 单位在 cm/μm/nm 间反复横跳 | 读取层统一 SI 单位,展示层才做格式化;开尔文防呆:min(T) < 200 直接 raise |
倒不是说今年的工程就无懈可击——赛后的独立审计还是抓出了真问题,比如 Q2 与 Q3 的生产网格口径一度不一致(一个 100、一个 320,重跑脚本会得到与交付文件不同的结果)。区别是:今年的缺陷暴露在「复现一致性」层面,而去年暴露在「物理正确性」层面。两种债都要还,但前者顶多尴尬,后者致命。
AI Agent 来了,这场比赛变成了什么
今年规则里有一个变化:参考文献之前必须保留「AI 工具使用声明」一节,支撑材料里要附《AI 工具使用详情》。线上赛 + 三天 + 可联网。可见,AI 已经是每个队伍的「第四名队员」了。区别只在于你把它写成声明,还是假装它不存在。
成本结构:哪些能力在贬值
AI Agent 最先碾平的是「体力密度」高的环节:
- 文献与背景:去年查 SiC 红外色散的文献花掉小半天,今年中药材干燥动力学的综述、Fick 定律回归的惯例、Page 模型的谱系,一个下午就立起了参考书目;
- 工程杂务:LaTeX 排错、matplotlib 调参、xlsx 模板对齐——这些去年吃掉深夜的碎活,今年几乎不占预算;
- 初稿生成:代码骨架、图表脚本、文档模板,AI 的「从 0 到 0.6」快得惊人。
三天赛制里,省下来的每一个小时都会被重新投资到「从 0.6 到 1」的地方。这直接改变了比赛的产能曲线——今年我们有时间做网格收敛研究、不确定度量化和双内核对算,不是因为变强了,而是因为杂事被外包了。
判断力:哪些能力在升值
但 A 题这道题里,AI 恰恰在两个最关键的地方都可能翻车:
- 那条分数线。 与 在 OCR、在复制粘贴、在「根据题意补全公式」的生成里都是高危误读。AI 不会自己发现物理趋势反了——它会觉得 16.47 h 也是个不错的数;
- 参数简并与张冠李戴。去年 互相抵消的那种坑,本质是「多个错误伪装成一个正确答案」——AI 批量生产「看起来对」的中间结果时,这种伪装只会更高效。
所以人的位置变了:从「生产者」变成「审计员」。今年我们自己的实践就很说明问题——赛后那份代码审计报告的工作方式是 AI 式的独立复核:不采信项目文档的任何结论,直读赛题 PDF 公式原图、独立读取交付文件、跨问逐点比对、重跑关键数值实验。它抓出了网格口径不一致这种「跑对了、代码没对」的交付级缺陷。AI 最好的用法不是让它答题,而是让它当那个不困、不累、不讲情面的第二双眼睛。
未来评价:比赛会比什么
站在 2026 年往前看,我觉得数学建模这类线上赛的评价重心会不可避免地移动:
- 从「产出」转向「可辩护性」。当任何队伍都能三天产出一篇排版精美、图表专业的论文时,区分度只能来自:数字背后的证据链完不完整?守恒检验、收敛阶、不确定度、独立方法交叉验证——这些「自证清白」的构件会从加分项变成生存项。我们今年的「三层口径」报告(单值 + 离散区间 + 参数不确定度带)就是朝这个方向的努力。
- 题目设计会向「AI 易错点」倾斜。物理图像的判断(趋势反没反)、多源数据的一致性审计(附件 2 与附录 3 的失水速率其实有 2–3 倍出入,我们做了显式定量化而不是假装没看见)、经验公式的正确识读——这些需要「对真实世界有体感」的环节,会成为新的分水岭。
- 声明制度只是第一步。今天是「声明你用了什么」,明天可能就是「附上你的验证过程」甚至现场答辩、限时复现。当生成不再稀缺,验证就是新的硬通货。
至于「AI 会不会毁掉数学建模比赛」——我的答案和去年复盘的结尾是同一种诚实:工具从来只放大使用者的习惯。对一个习惯了「跑出个好看的数就交卷」的队伍,AI 会让这个习惯以更工业化的效率生产错误;对一个习惯了「每个数字都要被多个来源点头」的队伍,AI 是史上最有耐心的复核员。比赛筛选的从来都不是谁更会用工具,而是谁更值得被结果信任。
结语
去年的结语里我写:模型永远是对真实世界的粗糙近似,发现「运气撑住的梁」并换掉它的过程同样快乐。今年这根药材让我补上了下半句——把梁换成钢的最好时机,是比赛结束之前。那条差点被读丢的分数线、那组两两相消的随体对流项、那张贴着机器精度的守恒残差表,都是二周目玩家从一周目的废墟里捡回来的装备。
至于 AI 时代的建模比赛会变成什么样,我谨慎乐观:当「写」不再稀缺,「想清楚」和「验明白」反而会被重新定价。药材在 58 小时里把水分一点点交还给热风;我们在两个九月里把侥幸一点点交还给方法。烘干结束,判据达成,可以出炉了。
愿每一阵吹进烘房的热风,带走的都是被计算过的水分。(´。• ᵕ •。`)
论文与支撑材料清单
- 论文:《基于热质耦合模型的药材烘干过程模拟与烘干时间预测》(2026 年高教社杯全国大学生数学建模竞赛 A 题提交论文)
- 代码:
q1/(常物性内核 + Bessel 对照 + 灵敏度)、q2/(变物性耦合求解 + 收敛与守恒检验)、q3/(极值追踪 + PCHIP 求根 + 不确定度分析)、q4/(Landau 变换移动边界内核 + 三算例定界)、common/(Thomas 追赶法与 PCHIP 统一实现) - 数据:附件 1(烘房温湿度 0–4 h)、附件 2(半径收缩 72 h,145 点)
- 校验:质量守恒残差 8.7×10⁻¹⁵、能量守恒残差 1.8×10⁻¹¹、移动/固定双内核对算偏差 2×10⁻¹⁴、网格收敛序列 N=160/320/640
- 其他:代码审计报告、扩散系数公式修正说明、AI 工具使用详情(2026 新规要求)